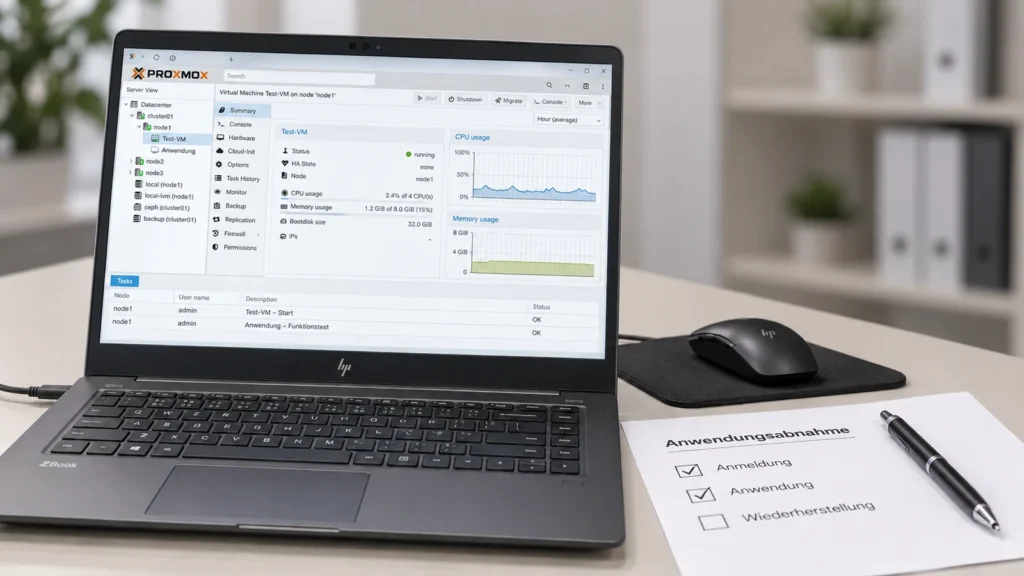
Un clúster puede absorber el fallo de un host de virtualización si se cumplen sus requisitos. Esto no repara automáticamente un archivo eliminado por error ni una aplicación dañada. La alta disponibilidad y las copias de seguridad responden a escenarios de fallo distintos.
¿Qué fallo debe cubrir la HA?
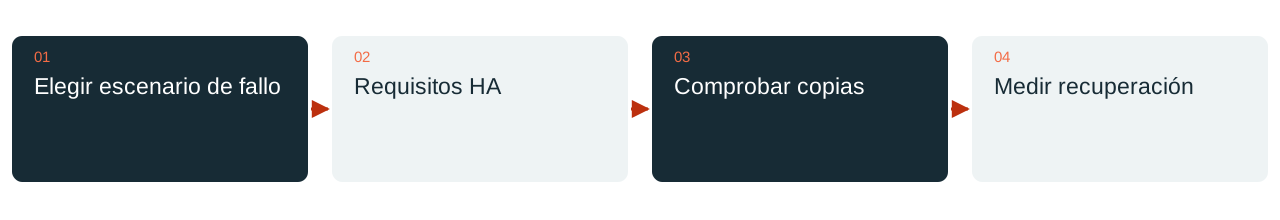
Proxmox HA supervisa los servicios configurados y puede reiniciarlos en nodos disponibles tras un fallo adecuado. El proceso incluye detección, aislamiento seguro del nodo fallido mediante fencing y un nuevo arranque. No se deriva de ello una promesa general de funcionamiento ininterrumpido de la aplicación.
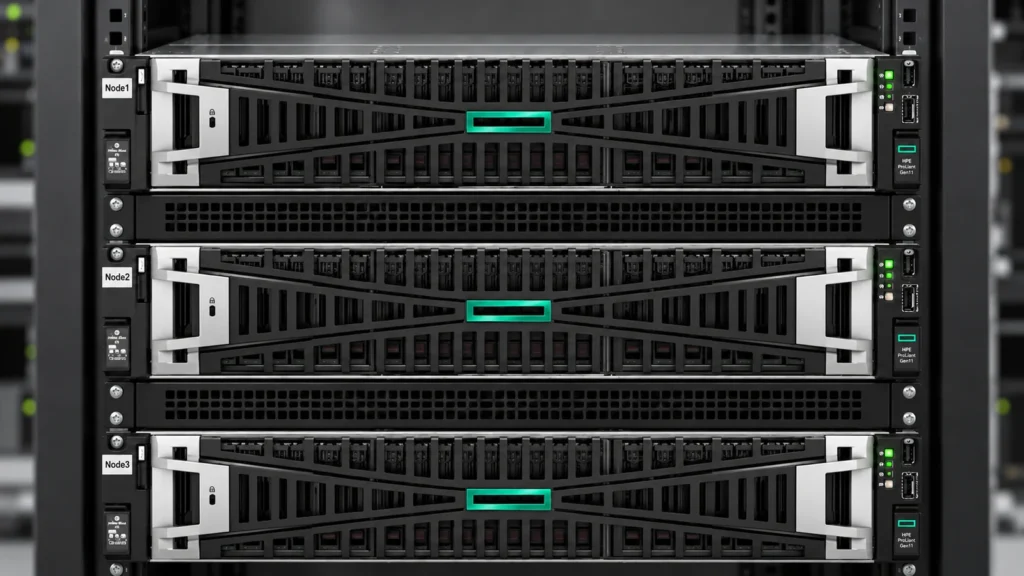
El cuórum, el fencing, la red y una estrategia de almacenamiento adecuada forman la base. La documentación del fabricante cita al menos tres nodos de clúster para un cuórum fiable como requisito habitual de HA. Las arquitecturas diferentes se evalúan por separado; un pequeño dispositivo adicional no sustituye automáticamente todos los recursos y las rutas de almacenamiento necesarios.
Los recursos restantes deben ser suficientes
Después del fallo de un host, los sistemas restantes deben poder soportar los servicios previstos. Esto incluye memoria, capacidad de cálculo, red y los datos realmente accesibles. La carga habitual de todos los nodos no demuestra por sí sola que exista esa reserva.
La decisión sobre almacenamiento se planifica expresamente. El almacenamiento compartido tiene dependencias propias y la replicación tiene su propio comportamiento de actualización de datos. Por ello, un diagrama de clúster con varios recuadros no demuestra qué estado de los datos estará disponible ni si el rendimiento tras un fallo será suficiente. El escenario relevante se prueba en la práctica.
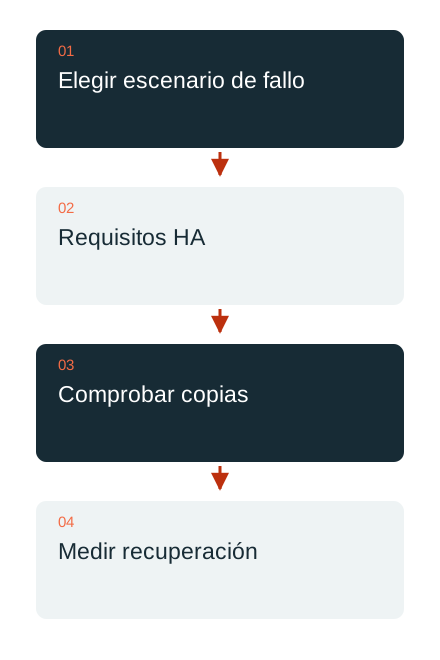
Las copias conservan otro estado
La HA también puede seguir operando con un estado de datos ya erróneo. Para contenidos eliminados, aplicaciones dañadas o determinadas consecuencias de un ataque se necesita una copia independiente adecuada. La conservación, los accesos y el entorno de recuperación forman parte de este diseño.
La prueba de restauración comprueba un proceso empresarial seleccionado. Arrancar una VM es un paso técnico intermedio; la persona responsable debe poder utilizar la aplicación con los datos necesarios. El tiempo de recuperación alcanzable y la pérdida de datos aceptable se describen y miden como objetivos concretos.
Planificar la disponibilidad como un sistema conectado
La evaluación no termina en el software de virtualización. La alimentación, la red, el DNS, las identidades y el almacenamiento pueden ser puntos de fallo comunes. Una ventana de mantenimiento necesita un plan para los recursos restantes y una vía de retorno adecuada.
DAXS planifica Proxmox según las aplicaciones y las necesidades operativas. Un único host con buenas copias puede ajustarse a una necesidad concreta; otros entornos necesitan un conjunto HA correctamente dimensionado. La decisión se basa en el riesgo de fallo real y la recuperación demostrada, no solo en el número de servidores disponibles.
Infraestructura y plataformas · Copias y recuperación · Hablar de los objetivos ante fallos
Fuentes: Proxmox: requisitos HA documentados (enlace externo) · Proxmox: funciones y opciones de recuperación (enlace externo)