Ceph en un clúster Proxmox puede distribuir los datos de las VM entre SSD locales de varios hosts y sustituir una SAN separada. Lo decisivo es qué ocurre con las copias tras fallar un host: ¿bastan quórum, capacidad libre y red para restaurar a tiempo la redundancia deseada? El cálculo siguiente separa datos accesibles, reinicios automáticos de VM y tiempo real de recuperación.
Este artículo se centra en la mecánica de Ceph en operación. La lista concreta de componentes HPE requiere un diseño de hardware propio; elegir entre Ceph, replicación ZFS y almacenamiento externo necesita otra comparación de aplicaciones. El escenario base usa SSD empresariales locales como OSD individuales de Ceph, un pool de VM replicado y el host como dominio de fallo. Los medios de arranque y la copia externa quedan fuera del pool.
¿Cómo hacen accesibles los SSD locales los datos de las VM?
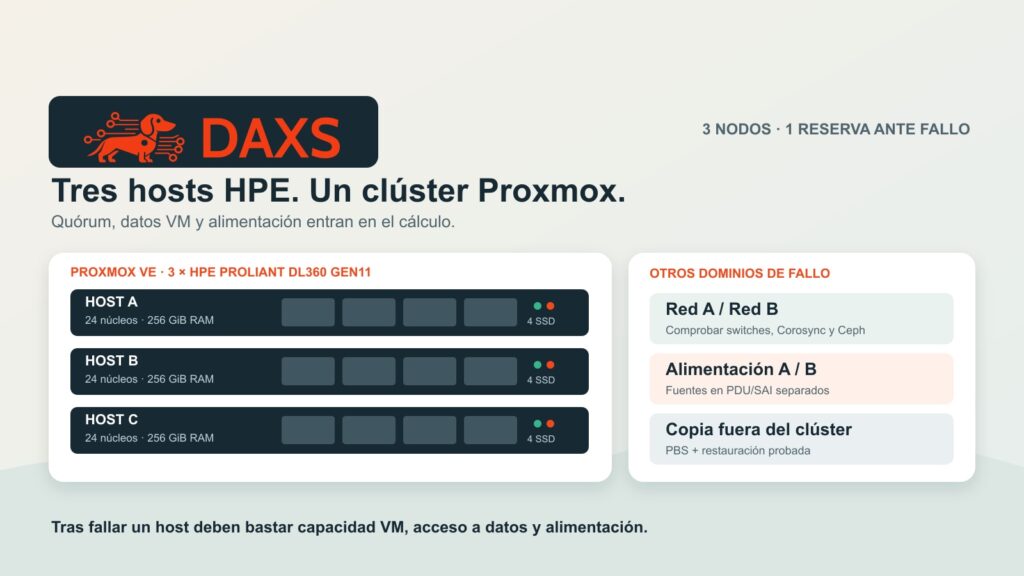
Ceph distribuye objetos de datos a los OSD mediante grupos de ubicación. La regla CRUSH determina qué hosts alojan copias. En este ejemplo fijamos expresamente size=3 y min_size=2: tres copias incluida la primaria, con E/S si al menos dos son accesibles. Las copias en tres OSD del mismo host no darían protección triple frente a su fallo. Quórum de monitores, estado OSD y acceso a datos de VM se comprueban por separado. El clúster Proxmox necesita al menos tres votos para un quórum HA fiable; se suman quórum de monitores Ceph y reglas HA de las VM.
Si falla uno de exactamente tres hosts, la replicación correctamente distribuida deja dos copias en hosts. En las condiciones indicadas, el pool puede atender E/S degradadas, pero la tercera copia en un tercer dominio de host solo existe cuando vuelve o se sustituye un host. Con cuatro hosts, Ceph puede reconstruirla en el cuarto si hay espacio y rendimiento libres. Es la diferencia práctica entre «los datos siguen accesibles» y «se restaura la redundancia durante el fallo». Incluso con Ceph una VM puede detenerse y reiniciarse después en otro host; no implica cero segundos de interrupción.
Calcular capacidad con reserva para fallos
Supongamos cuatro SSD de datos locales de 1,92 TB decimales por host. Tres hosts aportan 23,04 TB brutos; cuatro, 30,72 TB. Con tres copias, antes de metadatos, snapshots y reservas operativas, quedan teóricamente 7,68 o 10,24 TB lógicos. Un límite de planificación hipotético del 70 por ciento da inicialmente 5,38 o 7,17 TB. No es un valor predeterminado de Ceph ni un volumen útil garantizado.
| Magnitud que comprobar | 3 hosts | 4 hosts |
|---|---|---|
| Bruto / lógico teórico | 23,04 / 7,68 TB | 30,72 / 10,24 TB |
| 70 % de la capacidad lógica teórica | 5,38 TB | 7,17 TB |
| Tras el fallo de un host | Dos copias en hosts; tercera tras sustitución | Tercera copia posible en los tres hosts restantes |
| Límite del 70 % tras reconstruir en 3 hosts | No alcanzable sin tercer host | 23,04 ÷ 3 × 0,70 = 5,38 TB |
Para mantener el clúster de cuatro hosts por debajo del límite elegido incluso tras fallar uno, una vez terminada la reconstrucción, el ejemplo planifica como máximo alrededor del 70 por ciento de la capacidad restante: 5,38 TB lógicos, no 7,17 TB. También son decisivos los OSD más llenos y los umbrales Ceph de nearfull, backfillfull y full. Un solo OSD lleno puede bloquear escrituras o backfill aunque el total parezca correcto. Los TB decimales no son TiB binarios.
¿Cuánto tarda la reconstrucción?
Con, por ejemplo, 5 TB lógicos y tres copias, el conjunto de cuatro hosts contiene 15 TB brutos, idealmente 3,75 TB por host. Al fallar uno, deben transferirse unos 3,75 TB a los tres restantes para la tercera copia. Con una velocidad de reconstrucción efectiva medida de 250 MB/s, 3,75 TB ÷ 250 MB/s = unas 4 horas 10 minutos es un límite inferior aritmético; a 125 MB/s, unas 8 horas 20 minutos. Peering, distribución, E/S concurrentes de VM, límites de recovery y nuevas escrituras alargan el tiempo real. La velocidad nominal de una tarjeta de 25 Gbit no es esa medición.
DAXS exigiría una prueba de fallo con carga de aplicación activa: observar ceph health detail, ceph osd df y la evolución de los grupos de ubicación, registrar bytes reales recuperados y duración, y medir latencia y disponibilidad de las VM. En funcionamiento normal los PG deben volver al estado active+clean . La prueba debe mostrar si un fallo de switch, enlace o alimentación afecta simultáneamente al quórum Corosync o al tráfico Ceph. Proxmox recomienda al menos 10 Gbit/s exclusivos para Ceph y más con SSD rápidos; el plan de puertos depende del rendimiento OSD, objetivo de recuperación y rutas físicas separadas.
¿Qué cuesta el dominio adicional de reconstrucción?
Para decidir el presupuesto, sea h el precio ofertado de un host completamente equipado, n la red redundante ya dimensionada para cuatro conexiones y b un servidor externo de copias con medios. Se suponen por host p euros anuales para servicio, energía y colocación. Solo en este modelo, instalación y aceptación son 100 horas × 90 € = 9.000 €; la operación, 60 horas × 90 € = 5.400 € al año. Se supone el mismo trabajo con tres y cuatro hosts, que debe estimarse de nuevo en la oferta concreta. Los precios oficiales de Proxmox VE Standard y Proxmox Backup Server Standard son 550 € por socket CPU ocupado y año y 2.240 € por servidor de copias y año, respectivamente. Se supone exactamente un socket ocupado por host. Todo es neto; sustituir por ofertas y esfuerzo reales.
| Variante | 3 años | 5 años |
|---|---|---|
| 3 hosts | 3h + n + b + 36.870 + 9p € | 3h + n + b + 55.450 + 15p € |
| 4 hosts | 4h + n + b + 38.520 + 12p € | 4h + n + b + 58.200 + 20p € |
| Sobrecoste del 4.º host | h + 1.650 + 3p € | h + 2.750 + 5p € |
La fórmula suma anualmente sockets Proxmox, PBS y 5.400 € de operación: con tres hosts 9.290 € más 3p, con cuatro 9.840 € más 4p. Un precio unitario de host 1.000 € mayor sube ambos horizontes de cuatro hosts 4.000 €; un coste anual por host 1.000 € mayor añade 12.000 o 20.000 €. Si la opción de cuatro hosts necesita otros switches, sumar la diferencia a n . Las copias Ceph siguen sin ser backup: sistema separado, copia externa y restauración probada forman parte de la aceptación. El artículo DAXS Proxmox Backup Server: verificación, retención y restauración describe esta comprobación.
Decidir solo tras medir latencia, interrupción y reconstrucción y contar con una oferta sólida de hardware, red y operación. DAXS puede concretar con la empresa este protocolo de medición y aceptación a través de Contacto .
Fuentes: Proxmox VE Administration Guide: clúster y Ceph · Ceph: size y min_size · Ceph: controles de salud y ocupación · Ceph: recovery y backfill · Proxmox VE: precios · Proxmox Backup Server: precios.