Ceph, replicación ZFS y un SAN o NAS externo pueden ayudar a las VM Proxmox a superar un fallo de host. Difieren en actualidad de datos, recuperación y dominio de fallo. Marcar solo «alta disponibilidad» suele ocultar el requisito real: ¿cuántos minutos de pérdida de datos tolera la aplicación (RPO) y cuándo debe volver a ser utilizable (RTO)?
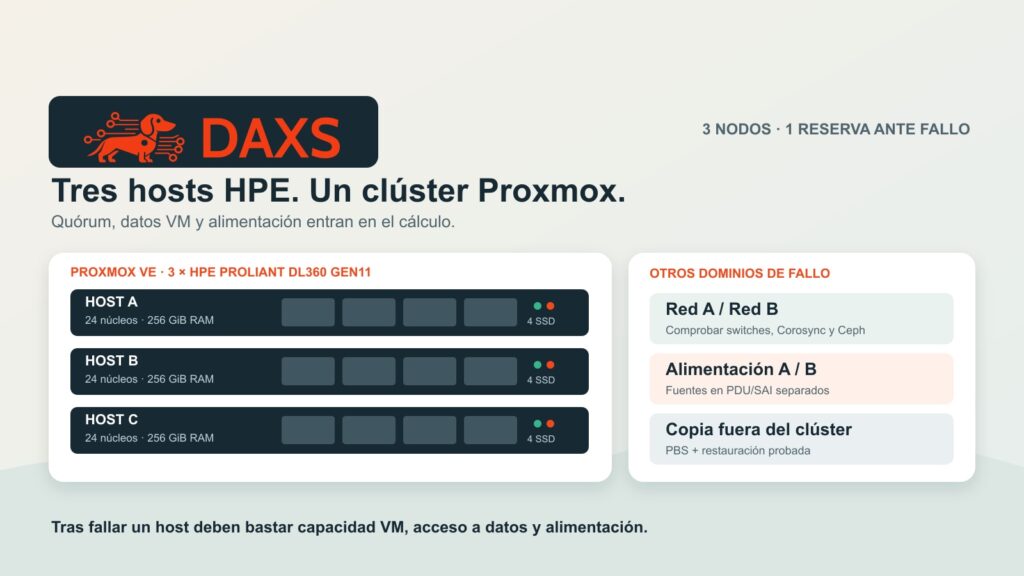
Comparamos tres vías de almacenamiento para el mismo clúster hipotético de tres hosts. Cómo Ceph reconstruye copias tras un fallo de host se describe por separado. Aquí se parte de las aplicaciones y sus objetivos de recuperación verificables. Las tres vías necesitan además copia de seguridad separada y prueba de restauración.
Tres arquitecturas, tres vías de fallo distintas
Ceph en SSD locales presenta el disco de la VM como almacenamiento de bloques distribuido y accesible en el clúster. Un pool replicado guarda copias en varios hosts; quórum, regla del pool, red y capacidad libre deben corresponder al dominio de fallo host elegido. Si falla el host de la VM, Proxmox HA puede reiniciarla en otro si hay quórum y recursos. Aun así, escritura en curso, aplicación invitada y transacciones deben evaluarse en la prueba. La redundancia Ceph por sí sola no promete VM sin interrupción ni RPO cero garantizado para cada aplicación.
ZFS local con replicación de almacenamiento Proxmox transfiere volúmenes VM periódicamente mediante snapshots a otro host. El destino tiene el estado de la última replicación completada correctamente . Proxmox permite HA con esa replicación, pero advierte de posible pérdida desde la última sincronización. Un intervalo configurado de cinco minutos no es un compromiso RPO general: cuentan retrasos, tareas fallidas y estado de la aplicación. Sin disco compartido síncrono, la VM reiniciada debe poder tratar exactamente ese estado anterior.
El almacenamiento compartido externo como NFS o iSCSI hace accesibles los discos VM a varios hosts y suele permitir migración en vivo sin copiar el disco. Ante un fallo de host, el riesgo de datos depende del diseño real. Comprobar dos controladoras, rutas de datos y alimentación separadas, multipathing iSCSI o rutas de red NFS redundantes, soporte y failover de controladora probado; un NAS único sigue siendo un dominio central de fallo. Proxmox advierte expresamente que un equipo ZFS-over-iSCSI no debe ser punto único de fallo. «Shared» en la configuración no demuestra una appliance redundante.
¿Qué carga tolera qué RPO y RTO?
RPO mide la pérdida máxima de datos aceptada; RTO el tiempo máximo hasta una aplicación utilizable. Lo siguiente son preguntas de decisión, no SLA de producto. En cada servicio deben probarse juntos base de datos, reinicio VM, DNS, inicio de sesión y sistemas dependientes.
| Aplicación y objetivo | Vía plausible | Comprobación decisiva |
|---|---|---|
| Base ERP transaccional; apenas se tolera pérdida de datos | Ceph o almacenamiento compartido con redundancia demostrada; quizá replicación propia de la aplicación adicional | Latencia de escritura, coherencia transaccional, quórum y reinicio real con fallo de host/almacenamiento |
| VM interna de pruebas o web recuperable; se aceptan minutos de pérdida | ZFS local con replicación puede bastar | Antigüedad del último snapshot correcto, alerta por retraso, inicio con datos anteriores |
| SAN/NAS existente con soporte y reserva suficiente | Seguir utilizándolo como almacenamiento compartido puede ser económico | Probar juntos controladoras, rutas, energía, firmware, mantenimiento y failover real |
Para una base de producción con RPO muy exigente, la replicación ZFS asíncrona puede ser inadecuada aunque funcione el reinicio HA. Un servicio de pruebas recuperable tampoco justifica automáticamente Ceph. Tres hosts Proxmox no hacen redundante un único servidor de almacenamiento. La elección sigue la pérdida aceptada y la interrupción medida, más allá del nombre del producto.
Cálculo a tres y cinco años sin precios de mercado inventados
El comparativo hipotético supone tres hosts iguales con un socket y precio de compra h por host, y un servidor de copias separado con medios al precio b . Según la lista actual del fabricante, Proxmox VE Standard cuesta 550 € por socket CPU ocupado y año; Proxmox Backup Server Standard, 2.240 € por servidor y año. El soporte común es 3 × 550 + 2.240 = 3.890 € anuales. El modelo usa 90 € netos por hora de trabajo. No supone IOPS ni capacidad útil iguales sin comprobar: las ofertas deben normalizarse primero para la misma carga.
d representa SSD de datos Ceph adicionales por host, z equipamiento SSD ZFS local por host, a una appliance externa de diseño redundante, nc, nz y ns las inversiones de red o fabric necesarias en cada vía. ec, ez y es son costes adicionales anuales de energía/colocación; s es el contrato anual de servicio del fabricante de la appliance externa. Todas las letras son importes netos ofertados en euros, no supuestos precios de mercado.
| Vía | Instalación / operación anual | 3 años | 5 años |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32.370 + 3ec € | 3h + b + 3d + nc + 49.150 + 5ec € |
| Replicación ZFS | 50 h / 30 h | 3h + b + 3z + nz + 24.270 + 3ez € | 3h + b + 3z + nz + 37.450 + 5ez € |
| Almacenamiento externo | 60 h / 35 h | 3h + b + a + ns + 26.520 + 3s + 3es € | 3h + b + a + ns + 40.600 + 5s + 5es € |
Las horas son supuestos del modelo, no tarifa plana DAXS. Ejemplo: 1.000 € más de servicio anual de appliance aumentan la opción externa 3.000 € a tres años y 5.000 € a cinco. Una appliance existente puede reducir a en el periodo, pero vida restante, soporte, repuestos y ampliación deben incluirse en s o en otra inversión. Precios de hardware, uso de capacidad, perfil de rendimiento, red, impuestos y lugar de operación deben acreditarse con ofertas. La fórmula más baja no decide una compra sin igual capacidad útil, IOPS, RPO y RTO.
Aceptación: probar realmente un fallo por dominio
DAXS exigiría cuatro pruebas por arquitectura candidata: (1) registrar el momento del último estado coherente de la aplicación, (2) medir fallo de host y reinicio VM con carga, (3) provocar además el fallo de la ruta crítica de almacenamiento o red y (4) restaurar una VM y datos individuales desde una copia separada . Para ZFS incluir tareas de replicación fallidas o tardías; para Ceph, pool degradado y reconstrucción; para SAN/NAS, cambio de controladora y ruta. Las mediciones deciden si se cumplen RPO y RTO.
Copias Ceph, snapshots de replicación y espejos de array también propagan borrados y datos erróneos. No sustituyen versiones, copia externa ni prueba de restauración. El artículo DAXS Proxmox Backup Server: verificación, retención y restauración profundiza en la aceptación de copias. Con un inventario de aplicaciones y objetivos RPO/RTO, mediante Contacto se pueden medir con DAXS las tres vías frente a carga real y contratos existentes.
Fuentes: Proxmox VE Administration Guide: almacenamiento, replicación de almacenamiento y HA · Proxmox VE: precios actuales de soporte · Proxmox Backup Server: precios actuales de soporte.